互联网数据服务 构建安全、可扩展且高性能的大规模数据处理、存储与网络服务体系
引言
随着移动互联网、物联网、人工智能等技术的快速发展,全球数据量呈现爆炸式增长。互联网数据服务作为支撑数字经济的基础设施,需要处理海量数据、存储PB级甚至EB级信息,并提供高并发的网络服务。在这一背景下,安全性、可扩展性和性能成为衡量互联网数据服务能力的核心指标。本文将探讨如何设计并实现一个能够支持大规模数据处理、存储和网络服务的互联网数据服务平台。
大规模数据处理
互联网数据服务每天需要处理来自各种来源的数据:用户行为日志、交易记录、传感器数据、社交媒体内容等。这些数据具有大体量(Volume)、多样性(Variety)、高速性(Velocity)和 value(Value)等特征。
数据处理架构
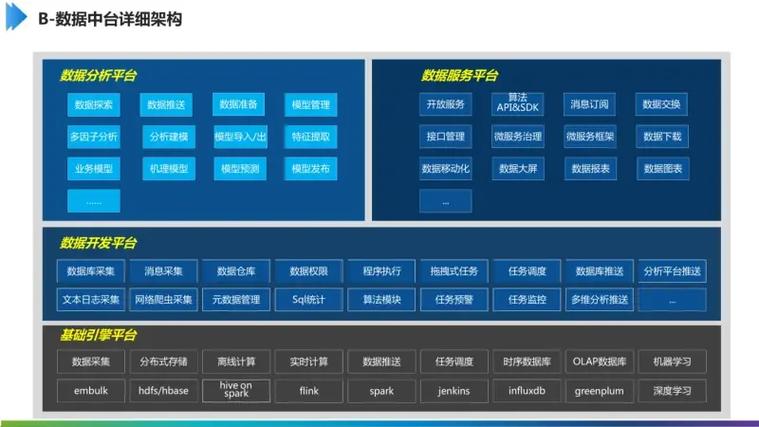
为了高效处理大规模数据,通常采用Lambda架构或Kappa架构,结合批处理和流处理。例如:
- 批处理层:使用Hadoop、Spark等框架对历史数据进行离线分析。
- 流处理层:使用Flink、Storm、Kafka Streams等实现实时计算。
- 服务层:将处理结果存储到数据库或缓存中,供上层应用查询。
在大规模场景下,数据分区、并行计算、任务调度和资源管理是关键挑战。YARN、Kubernetes等资源调度系统能够 dynamically 分配计算资源,提高集群利用率。
大规模数据存储
存储是互联网数据服务的基石,需要兼顾容量、吞吐量、延迟和持久性。根据数据类型和访问模式,通常采用分层存储策略:
- 热存储:如Redis、Memcached,用于缓存和高速访问。
- 温存储:如HBase、Cassandra,用于中等规模结构化数据。
- 冷存储:如HDFS、S3、OSS,用于海量历史数据归档。
分布式存储系统
分布式存储通过数据分片(Sharding)和副本(Replication)实现可扩展性和高可用性。例如:
- HDFS:主从架构,适合大文件顺序读写。
- Ceph:统一的分布式存储系统,支持对象、块和文件存储。
- TiDB:分布式SQL数据库,结合了OLTP和OLAP能力。
存储系统需要保证数据一致性(强一致或最终一致)、容错性和自动恢复能力。
大规模网络服务
互联网数据服务需要承受每秒数百万甚至数千万的请求。为了提供低延迟、高可用的网络服务,架构设计需考虑:
- 负载均衡:使用LVS、Nginx、HAProxy或云负载均衡器分发流量。
- CDN:将静态内容缓存至边缘节点,减少回源压力。
- 微服务与API网关:将系统拆分为细粒度服务,通过API网关统一入口,实现鉴权、限流、熔断等。
- 异步与消息队列:使用Kafka、RabbitMQ等解耦服务,削峰填谷。
安全性保障
安全性是互联网数据服务的生命线,涉及数据机密性、完整性和可用性。关键措施包括:
- 身份认证与授权:OAuth 2.0、JWT、RBAC等机制。
- 数据加密:传输层TLS/SSL,存储层AES加密,密钥管理KMS。
- 网络安全:防火墙、WAF、DDoS防护、VPC隔离。
- 审计与监控:日志记录、行为分析、入侵检测。
- 合规性:遵守GDPR、CCPA、等级保护等法规。
可扩展性设计
可扩展性决定了系统能否随着业务增长而平滑扩容。关键原则包括:
- 水平扩展:通过增加节点而非提升单机性能来扩展。
- 无状态服务:将状态外置到存储层,使服务层易于伸缩。
- 分片与分区:将数据和服务按规则拆分,避免单点瓶颈。
- 自动化运维:利用Kubernetes、Terraform等实现弹性伸缩和自动部署。
性能优化
性能直接影响到用户体验和资源成本。优化手段涵盖:
- 缓存:多级缓存(本地缓存、分布式缓存、CDN)。
- 索引与查询优化:合理设计数据库索引,使用列式存储。
- 并发与异步:非阻塞I/O、协程、响应式编程。
- 硬件加速:SSD、RDMA、GPU、DPU等。
- 性能测试与调优:持续压测,基于监控数据定位瓶颈。
结论
构建支持大规模数据处理、存储和网络服务的互联网数据服务平台,需要在安全性、可扩展性和性能之间取得平衡。通过采用分布式架构、分层存储、流批一体计算、微服务、加密与访问控制等技术,可以打造一个弹性、可靠、高效的数据服务基础设施,为上层业务提供强有力的支撑。随着5G、边缘计算和AI的融合,互联网数据服务将迈向更智能、更自动化的新阶段。
如若转载,请注明出处:http://www.gtkyx.com/product/56.html
更新时间:2026-10-15 05:25:43